 Omni小說館
2026 AI 旅遊照實測|Tour.ME 虛擬旅遊 14 天:五場對照實驗、六個穿幫破綻,還有你照片裡看不見的簽名
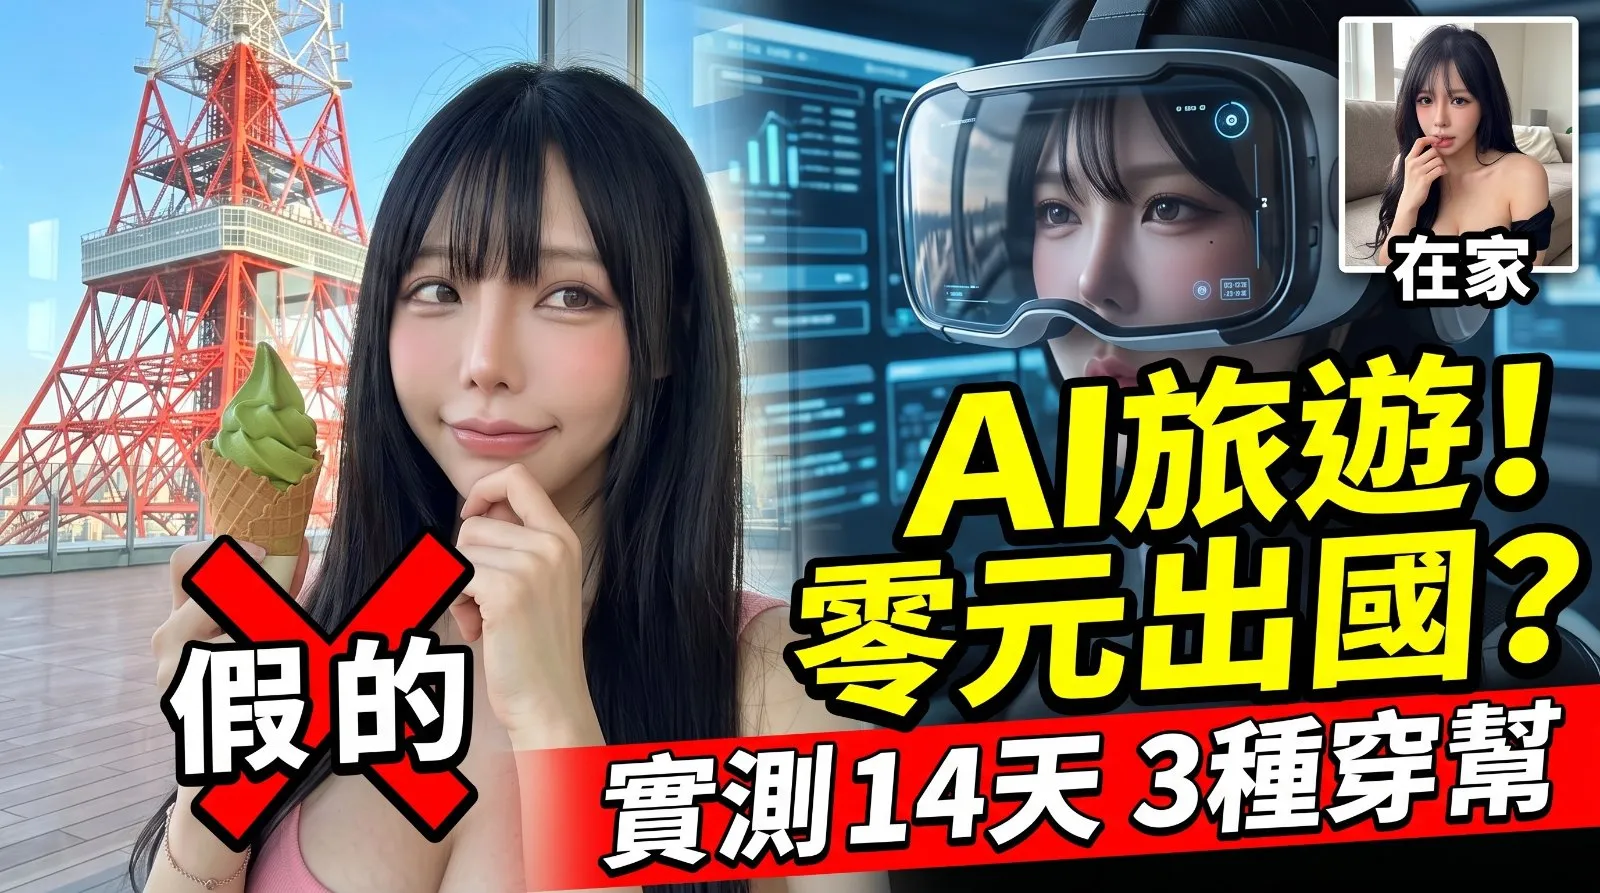
京都竹林、聖托里尼的藍頂、北海道雪地、冰島極光——這四張照片,我都「去過」。用的是一台筆電,穿著睡衣,手邊還有一碗泡麵。上傳一張臉,寫一句「黃昏的東京鐵塔」,三十八秒就出圖。
真正的問題是:這種照片過不過得了人眼那一關?我用 Tour.ME 測了十四天,整理出成功率最高的組合、三種一看就穿幫的照片,還有一個沒人告訴你的隱形標記。


這件事已經不是小眾玩法了
2026 年 7 月,「朋友圈開始用 AI 照片代替旅遊照」直接衝上熱搜。討論的重點很有趣:不是技術行不行,而是這樣算不算騙人。
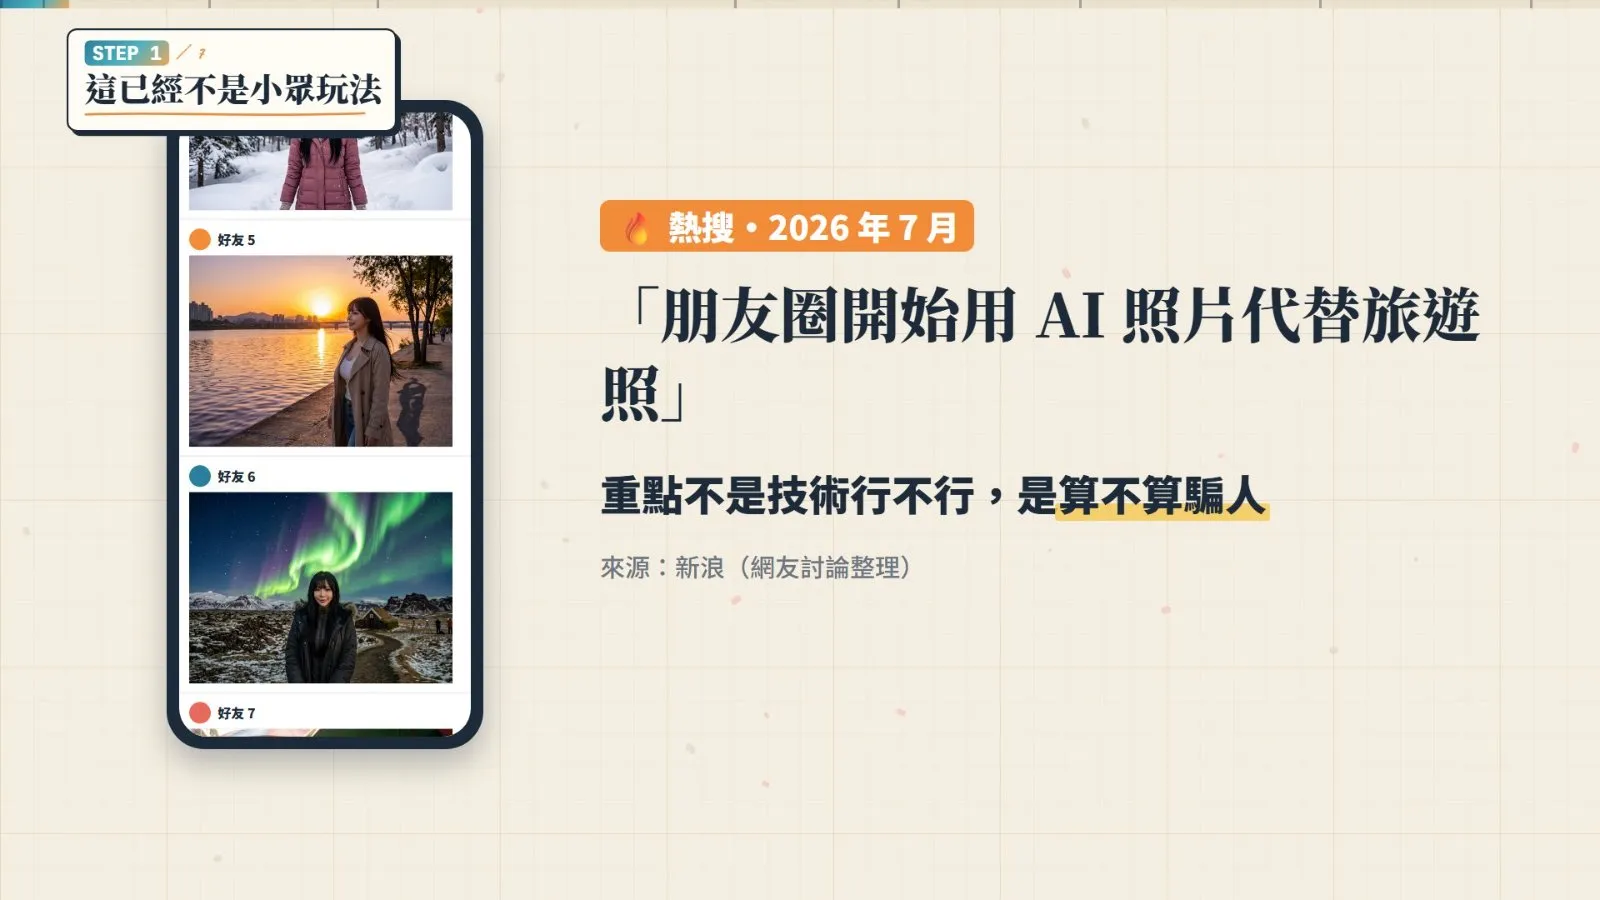
支持的人說,反正最後都是要發社群,AI 省掉規劃、人擠人、修圖,這叫效率;對時間不夠、預算不夠的人來說,這是低成本圓夢。反對的人則認為,修圖是美化,生成是無中生有,那是兩回事。有網友講了一句我覺得很到位的話:「向往遠方的心,從來都不是假的。」
同一年還發生三件事,剛好把這個問題的三個面向都攤開:
- 2026/07 呼和浩特攝影比賽:一等獎作品被網友揪出是 AI 生成,官方查證後撤銷所有獎項、賽事停辦整改。意義:比賽、投稿、商業用途是紅線。
- 2026/07 Meta Muse Image:可引用公開 IG 帳號照片生成影像,上線三天因隱私爭議喊卡。意義:「別人的臉」不能隨便丟進去。
- 2026/08 Google Earth AI 生圖:上線隔天急下架,因為有人拿它偽造巴黎爆炸、核設施等假衛星影像。意義:擬真度已經高到連 Google 都怕。

所以這篇不只教你怎麼按按鈕。我想知道兩件事:第一,它到底做得多真?第二,做出來之後,你能拿它幹嘛、不能拿它幹嘛?
Tour.ME 三步驟,和它藏起來的設計
介面只有三塊:左邊放人,右邊放地點,下面按生成。看起來很簡單,但每一步都藏了一個小知識。
步驟一:放人,關係欄是最被低估的一格
最多可以放五位旅人,每一位下面都有一個小欄位可以寫關係。這是整個工具最被低估的地方:寫不寫「情侶」,出來的照片差到像兩組不同的人。
步驟二:給地點,打字比上傳圖穩
地點有兩種給法:上傳背景圖,或用文字描述。第三方實測(電腦王阿達)在這裡踩過雷:上傳背景圖的效果明顯比較差,文字描述反而穩。原因不難理解,丟一張背景圖進去,模型要同時處理「保住你的臉」和「不能動這張背景」兩個約束,很容易合成感很重;打字的話,模型可以自己把人跟光影一起生出來。
步驟三:選風格、按生成
沒靈感的話,「生成新風格」會丟十個旅遊主題給你,像「紐約時代廣場的霓虹狂想」。好用歸好用,但先劇透:風格愈重,臉愈不像。生成完它還會順手寫好社群文案跟 Hashtag,有點諷刺:它連「你該怎麼說這趟旅行」都幫你想好了。
實測擂台:五場對照實驗
每場實驗固定節奏:宣告變因、直接給結果、再講判讀,最後蓋章:PASS、FAIL 或「可惜了」。
實驗一:臉好不好,差多少
同一句「台北 101」,A 組用隨手生活照(背景雜亂、側臉),B 組用單一背景的正面大頭照。B 組不只臉比較像,連光影都接得比較順。因為模型要先看懂你的五官才能重畫,背景愈乾淨、臉愈正,它要猜的東西愈少。一句話:把它當證件照在拍,不是當回憶在挑。
實驗二:一句話的威力,關係欄位
同樣兩個人、同樣「夕陽下的東京鐵塔」,A 組關係欄留白,B 組填「情侶」。留白的時候,兩個人站得像同事團建;填了情侶之後,女生直接靠到肩膀上,連視線都轉了。模型吃的不只是「誰」,還有「你們是什麼關係」。這格還可以寫得更細,例如「交往三年的情侶,剛吵完架在和好」。
實驗三:風格愈潮,臉愈陌生
同一張臉,A 組原版寫實,B 組套用「紐約時代廣場的霓虹狂想」。場景很漂亮,霓虹、反光、雨後地面都有了,但臉開始飄。風格指令會搶走模型的注意力預算,它先去伺候氛圍,才回頭處理你的臉。要炫就別要像,要像就別太炫,這是目前所有生圖工具的共同天花板。
實驗四:上傳背景圖 vs 純文字
A 組上傳《你的名字》須賀神社階梯的實景照,B 組只打「黃昏的東京舊街區石階,電線桿與斜坡」。這場最反直覺:給圖那組明顯像把人「貼」上去,比例對了但光不對;文字那組整張一起生出來,光影自然。結論:背景圖拿來當參考講給 AI 聽,不要拿來當底板叫 AI 填空;真的想用自己的照片,就「描述那張照片+上傳」雙保險。
實驗五:多人合照的崩壞臨界點
1 人、2 人、3 人到 5 人,其他條件全部固定。一到兩人幾乎都能用;三人開始出現「有一個人特別不像」;五人的時候,大概要生四、五次才有一張能看。
為什麼今年突然變像了?
先搞懂它在幹嘛。它不是把你的頭剪下來貼到風景上(那是 Photoshop),而是把你的臉當成一份規格書,然後重新畫一個人:眼距、鼻樑弧度、嘴角,全部重畫。所以它才能幫你轉頭、換角度、改光線,也因為是重畫,才會有不像的風險。
這件事的專業名稱叫人物一致性(Character Consistency),是整個產業過去兩年最難的題目。Google DeepMind 官方人工並排盲測換算的 Elo 分數中,多角色一致性從 Nano Banana 2 的 978、Nano Banana Pro 的 1011,到 Nano Banana 2.1 的 1106;單一角色則是 981、991、1028。這一代拉開一百多分,進步幾乎全集中在「多個人同時出現」這件事上,正好對應實驗五三人開始崩的問題。
但官方自己也在模型卡裡承認:輸入圖跟輸出圖之間的角色特徵對齊,還沒有完全穩定。所以不要期待每一張都中,這是機率遊戲。我的實務做法是一次生四到八張,挑一張,其餘全刪。
把它當底片,不當照片。一卷三十六張,能選出三張就夠了。
翻車實錄:一看就穿幫的六個破綻
- 手指數學題:這位朋友的左手,數了三次,每次結果都不一樣。
- 招牌亂碼:背景招牌上的字,查遍世界各國語言都查不到。這是辨識 AI 圖最快的一招:先看字。
- 影子打架:人的影子往左,旗桿的影子往右,等於圖裡有兩顆太陽。
- 路人複製貼上:背景三個路人是同一個人分身三次,髮型、包包、走路姿勢都一樣。
- 物理學休假:水流往上、欄杆穿過手臂、相機背帶接到空氣。呼和浩特那場比賽,網友就是從水壺造型跟水流方向抓到破綻的。
- 臉太乾淨:沒有毛孔、沒有雜毛、沒有不對稱。真人臉是歪的,AI 很愛幫你修正對稱,愈完美愈可疑。
反過來說,想讓它看起來像真的,就讓它有缺點。提示詞裡加「手機隨手拍、輕微晃動、沒有刻意擺姿勢」,比加「超高畫質、8K、電影感」有用得多,因為真實的照片本來就不完美。
你的照片其實偷偷簽了名
這是大部分教學不會提的事。用 Google 的模型生出來的每一張圖,裡面都已經被蓋了一個章,叫 SynthID。它直接改寫像素,人眼看不出來,但 Google 的偵測模型認得;它撐得過裁切、濾鏡、壓縮,截圖再上傳通常還在。依 iThome 報導,從 2026 年 11 月起,Google 旗下模型生成的圖會全面自動嵌入 SynthID 加上 C2PA 來源標準;OpenAI 在 2026 年 5 月也跟進雙標記。
更重要的是,SynthID Detector 從 2026 年 10 月 7 日起對全球一般使用者開放:任何人,包括你朋友,都可以把你發的照片丟上去驗。
不過 Google 自己也講得很清楚,這東西不是萬能的:測到浮水印不代表整張都是 AI 做的,可能只是局部修過;測不到也不代表就是真的。它不是測謊機,只是一條線索。
所以我的建議很簡單,三條線:
- 自己玩、做夢、送長輩:沒問題,這是這個工具最美的用途。
- 公開發布就標註一下:一句「AI 生成」不會掉粉,被抓包才會。
- 比賽、投稿、商業宣傳、新聞:絕對不要。那不是道德問題,是會被撤銷資格、會被告的問題。
四個進階玩法,把它從玩具變工具
旅程模式:單張照片是炫耀,一組照片是故事。讓 AI 先排一條路線,早上的市場、中午的拉麵店、黃昏的河堤、晚上的居酒屋,一站拍一張,發出去就是一篇遊記;輪播貼文的停留時間也遠高於單圖。
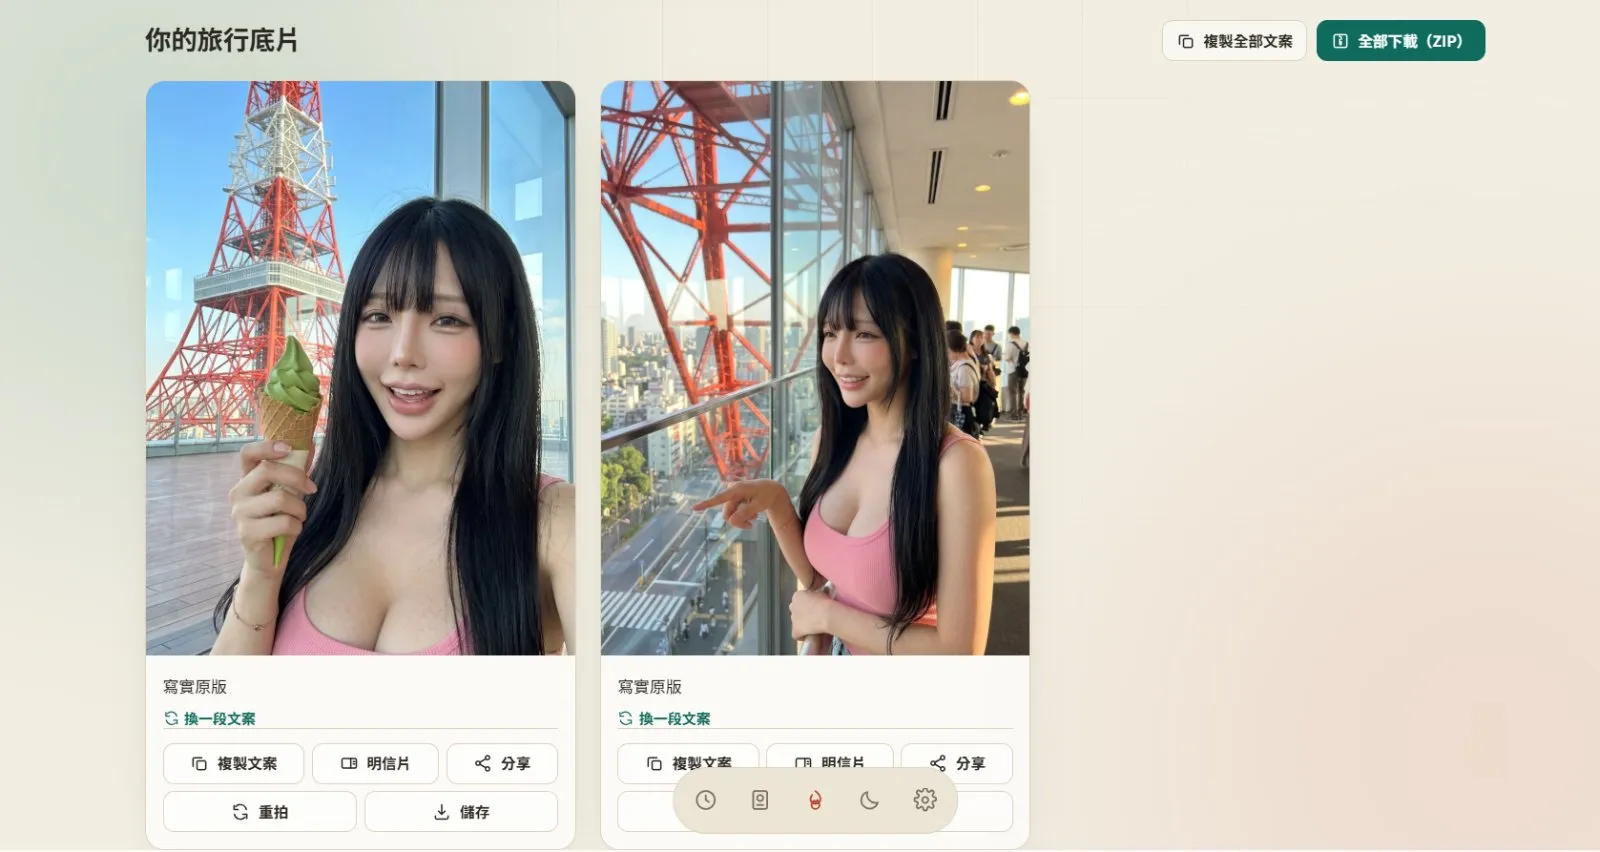
明信片:把照片加上郵戳、日期和手寫風格的一段話。重點不在好看,在於它一看就知道不是現場照,等於用形式本身做了誠實的標註,又不掃興,特別適合發給長輩。旅行護照:每完成一趟就蓋一枚章、累積旅人等級,人類就是喜歡集章。
最後一個不是技巧,是用途:幫走不動的人,去一趟。今年年初有一則討論叫「一張 AI 照彌補爺爺半生遺憾」。我也做了一次,把阿嬤年輕時的照片,跟她講了一輩子想去卻沒去成的地方合在一起。她看了很久,然後說:「欸,這件衣服我有。」她當然知道那不是真的,她只是,終於看到自己站在那裡了。
向往遠方的心,從來都不是假的。
結語:總結三句話
- 正面大頭照+文字描述+兩個人以內,這是成功率最高的組合。
- 要炫就別要像,風格跟相似度在打架。
- 自己玩隨便你,公開發就標一下。
最後問你一個問題:如果現在你可以零成本去任何一個地方拍一張照,你會去哪裡?不要寫巴黎、不要寫京都,寫一個對你有意義的地方。完整 14 分鐘的動畫實測在 YouTube 頻道「欣欣 的 AI 無限世界」,我會從留言挑十個,下集直接生給你看。
【Tour ME 虛擬旅遊APP連結】
https://share.gemini.google/cBLNs0L4F1J3
【Tour ME 虛擬旅遊工具APP實測影片連結】
#AI旅遊照 #虛擬旅遊 #SynthID #人物一致性
Omni小說館是 NovelPD Omni 的作品發表平台: 作者用 AI 從一句話寫出完整小說後一鍵發佈,讀者可免費線上閱讀,付費解鎖與打賞的收入由作者分潤最高 85%。 更多動態請見 小茉莉 的作者專頁 與 社群河道。