 Omni小說館
2026 開源 AI 繪圖模型 MOSS-Image 深度解析|會排版的 AI 畫師:一次寫上千字、用 JSON 指定每個字的位置,適合你嗎?
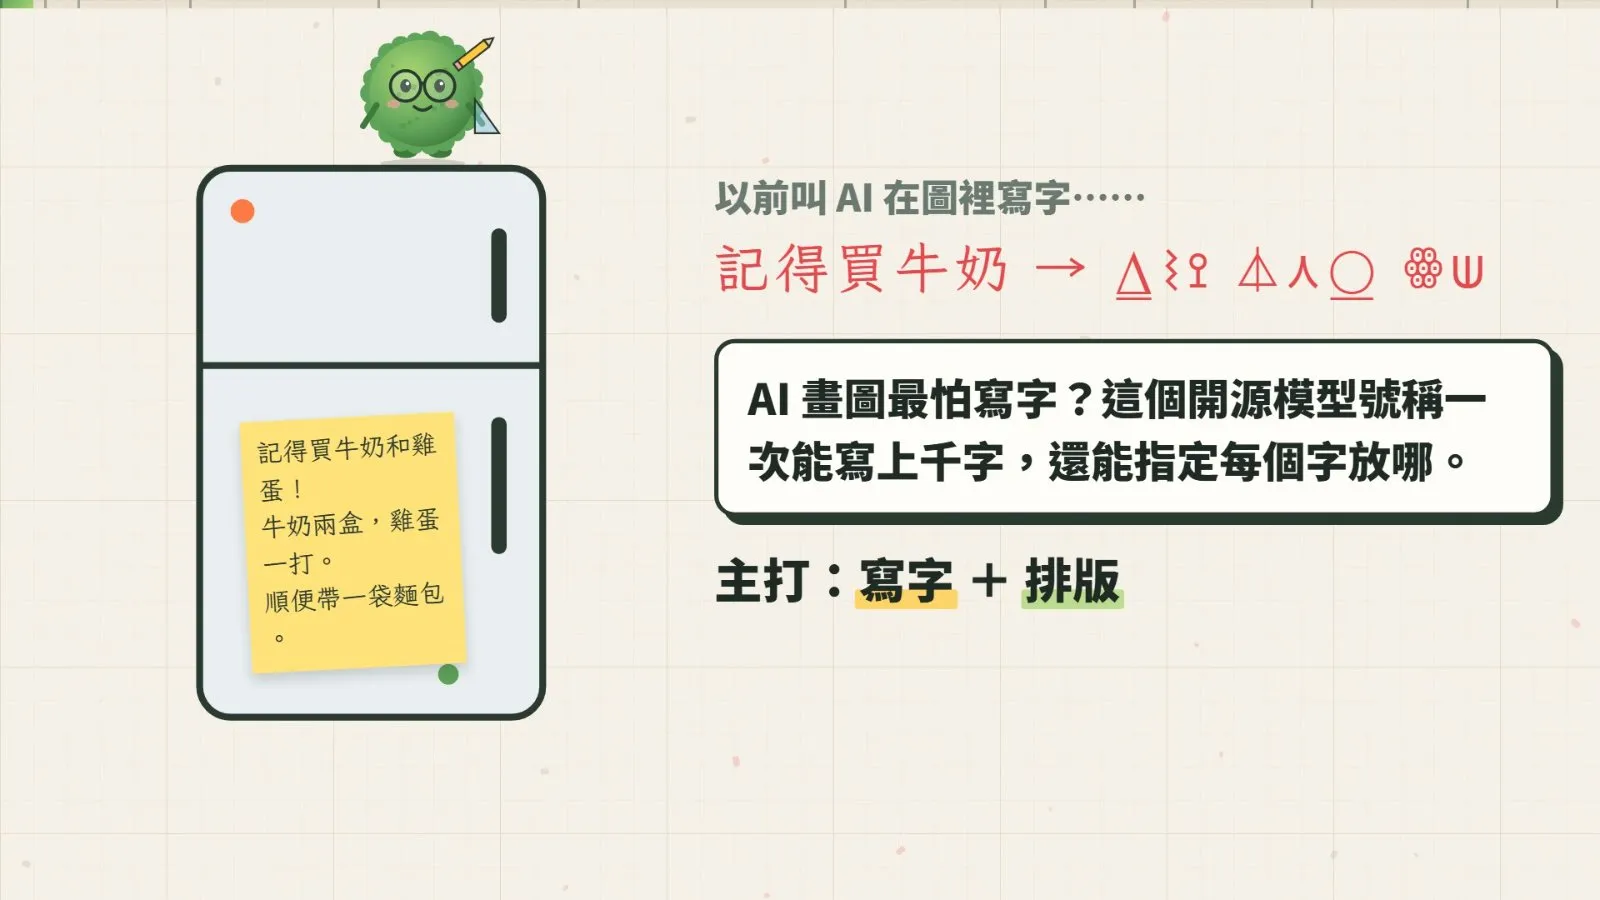
叫 AI 在圖裡寫字,你是不是也常看到一串像外星文的符號?文字渲染一直是繪圖模型的弱點,排版更不用說。2026 年 10 月 16 日開源的 MOSS-Image,主打的正是這兩件事:號稱一次能寫上千字,還能用 JSON 指定每個字、每個物件要放在畫面哪裡。
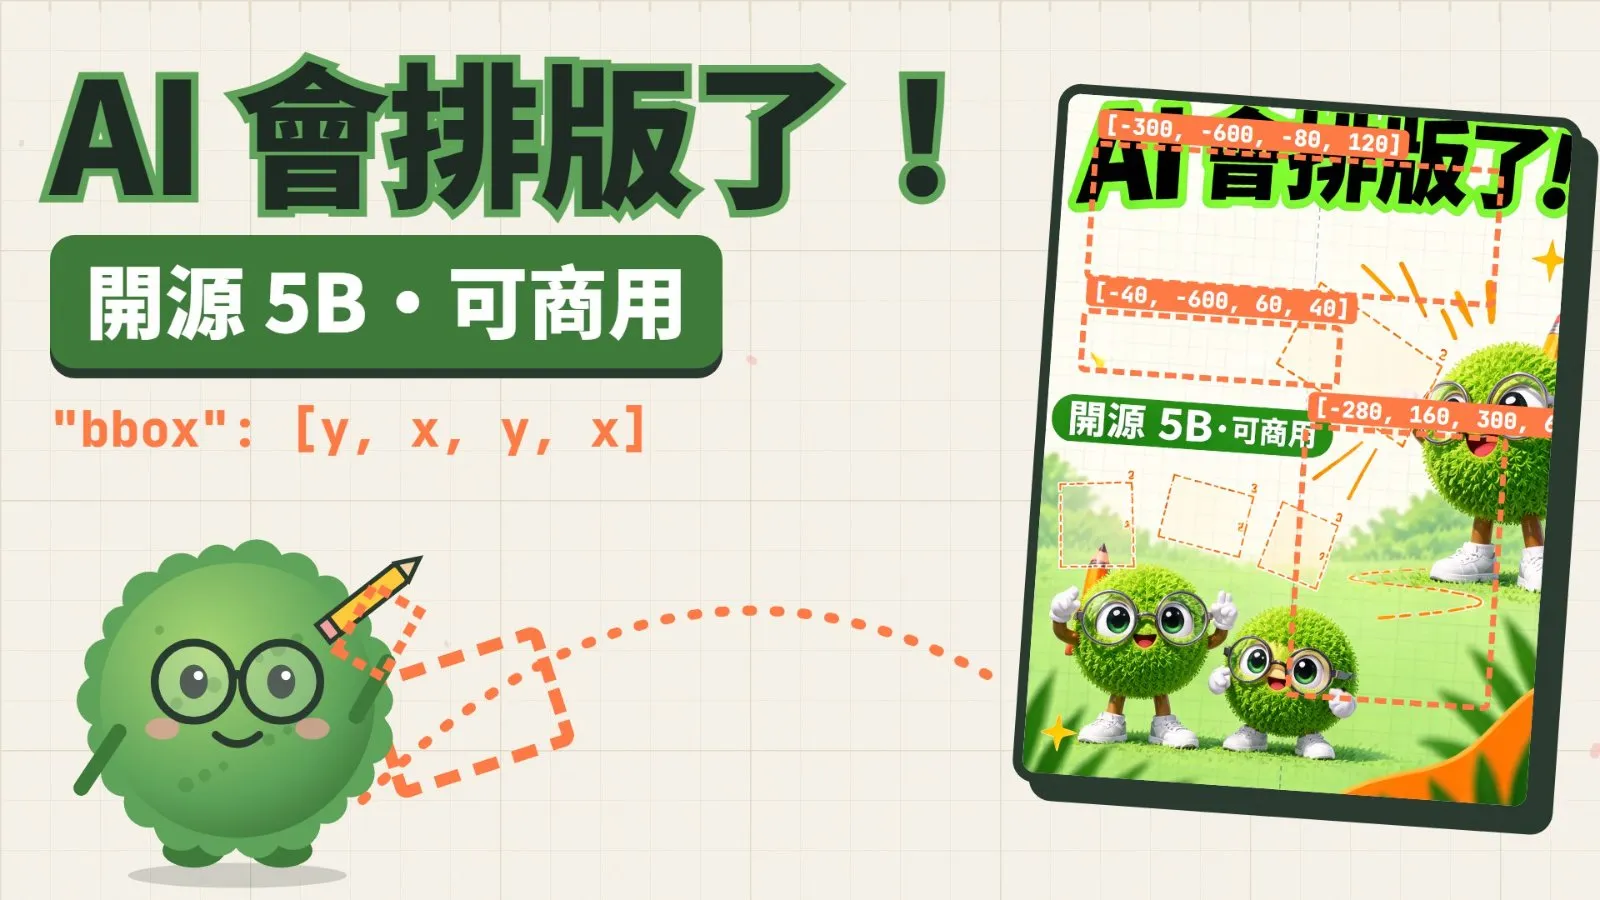
我是欣欣。這篇用評測的角度,把它的架構、亮點、跑分和使用門檻一次整理清楚。先說在前面:目前所有分數都是官方自建的測試,還沒有第三方獨立評測,我會在每個數字旁邊標清楚。
AI 畫圖最怕寫字?MOSS-Image 想解決的問題
一般繪圖模型靠「描述」理解你要的畫面:你寫「標題放在上面」,它只能猜大概的位置。MOSS-Image 多了一條路:直接把版面寫成座標。官方 Quick start 的示範,就是在冰箱便利貼上寫出三行繁體中文:「記得買牛奶和雞蛋!牛奶兩盒,雞蛋一打。順便帶一袋麵包。」
身世卡:誰做的、怎麼授權、去哪下載
- 開發團隊:OpenMOSS(SII),技術報告署名 MOSI Intelligence;MOSS 這個名字最早來自復旦大學的開源對話模型。
- 發布日期:2026 年 10 月 16 日,同時發布 MOSS-Image-Base 與 MOSS-Image-SFT 兩個版本。
- 開放程度:模型權重、推理程式碼、技術報告全部公開,採 Apache 2.0 授權,沒有營收門檻。
- 取得管道:Hugging Face、ModelScope,以及 Hugging Face Space 的線上 Demo。
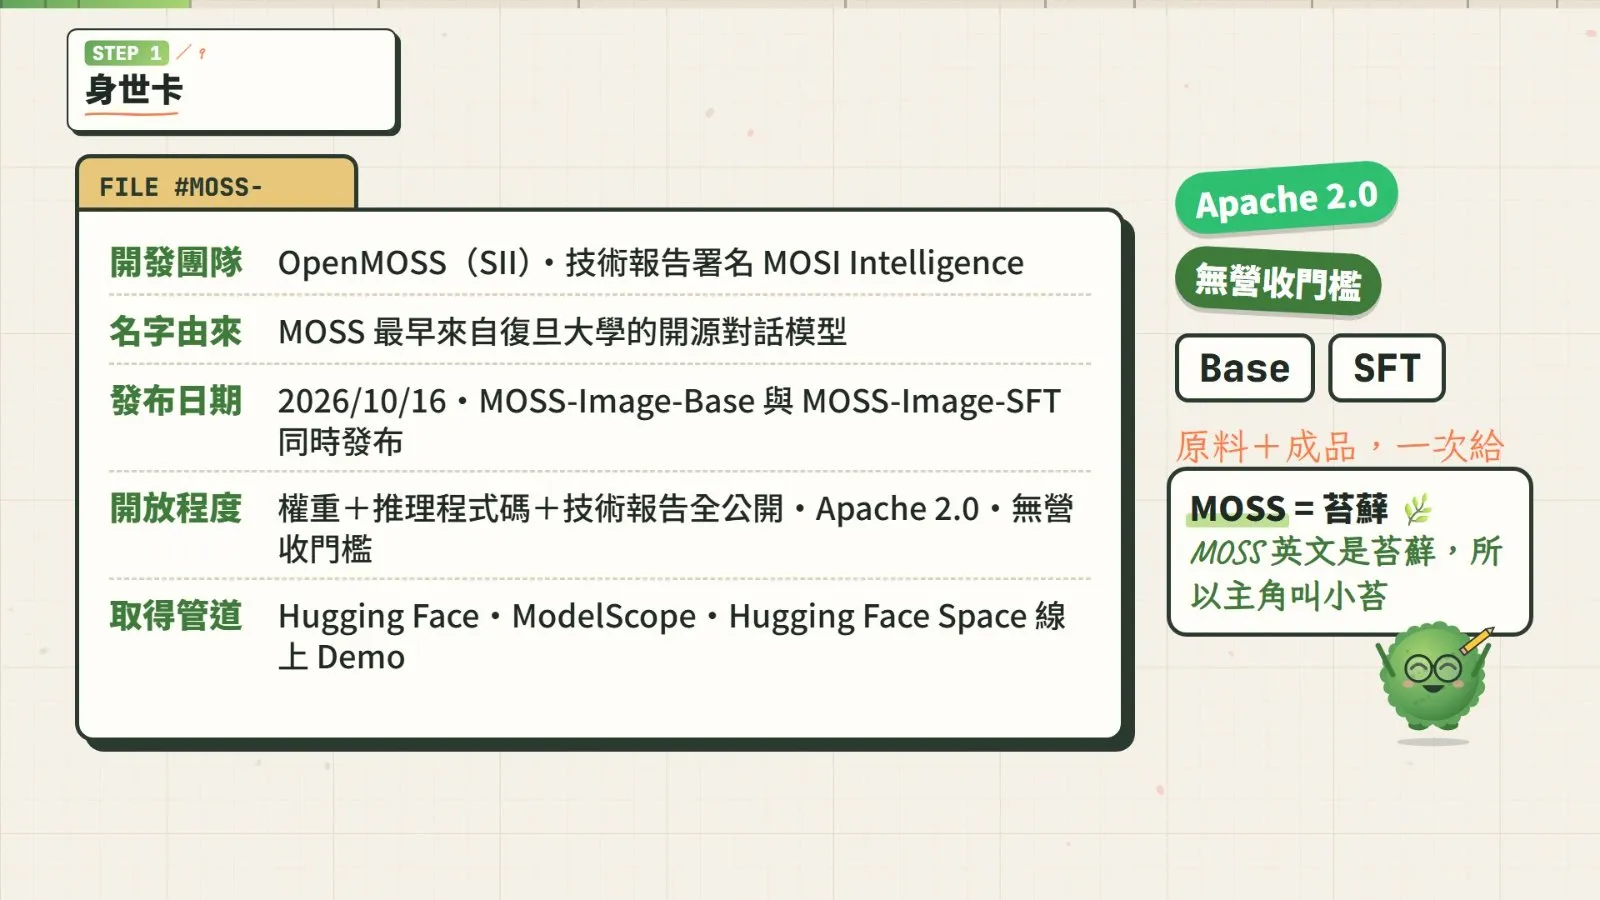
小彩蛋:MOSS 的英文是苔蘚,所以影片裡把它畫成一顆戴圓框眼鏡、耳朵夾著鉛筆的苔蘚球設計師「小苔」。
架構拆解:一條三人工廠流水線
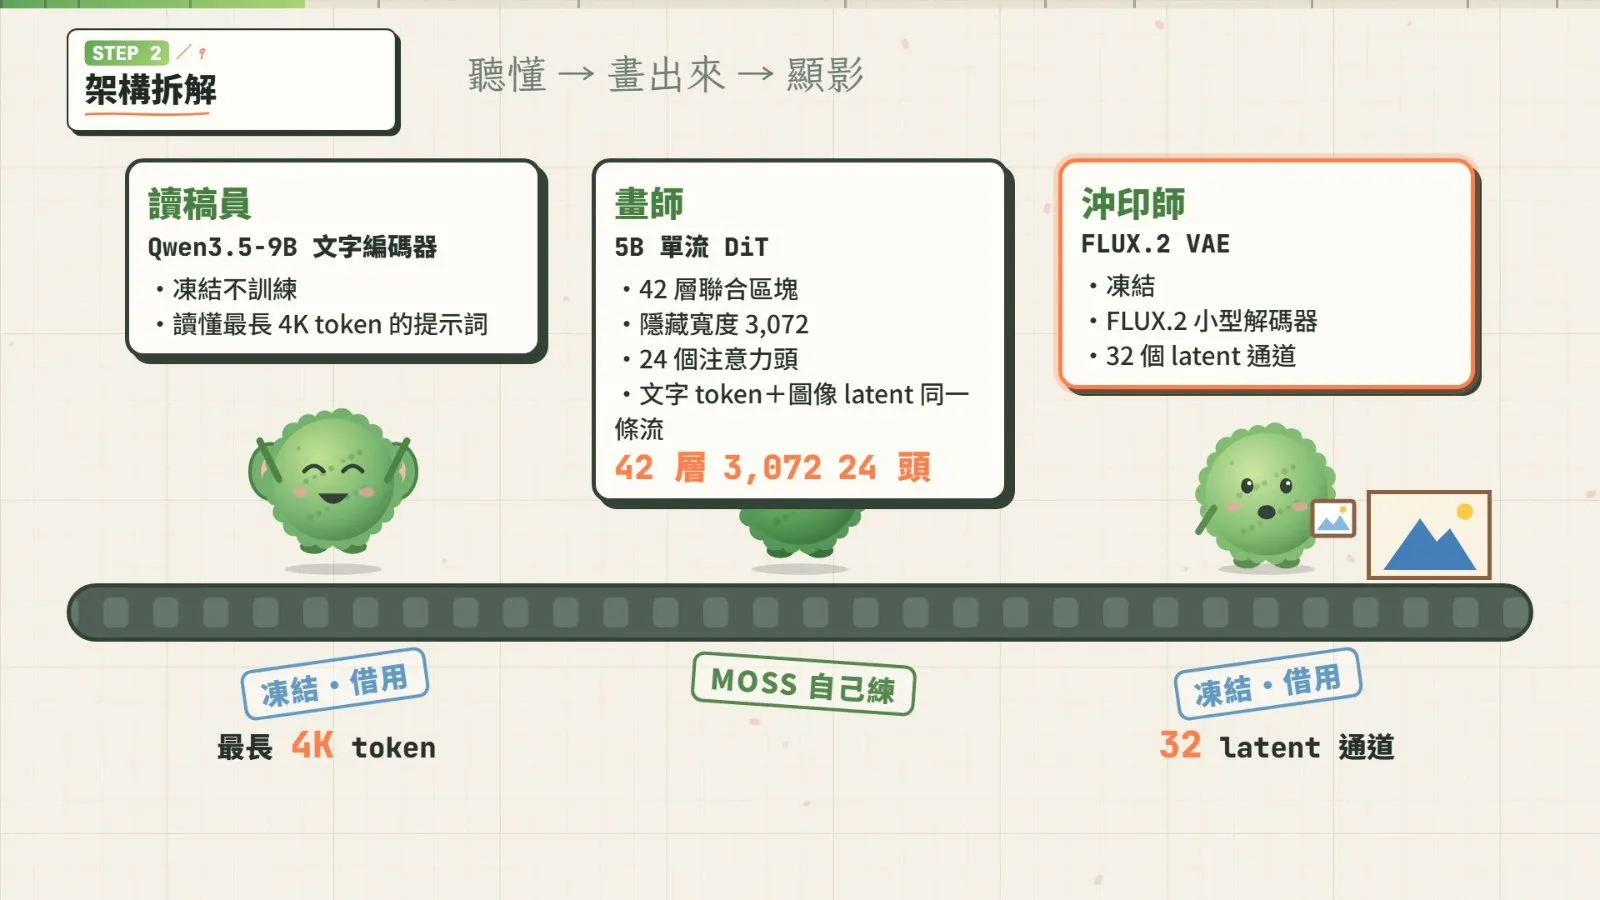
- 讀稿員:Qwen3.5-9B 文字編碼器(凍結不訓練),負責讀懂長達 4K token 的提示詞。
- 畫師:5B 單流 DiT,42 層聯合區塊、隱藏寬度 3,072、24 個注意力頭;文字 token 和圖像 latent 在同一條流裡一起處理。
- 沖印師:FLUX.2 VAE(凍結),採用 FLUX.2 的小型解碼器、32 個 latent 通道,把 latent 沖洗成照片。
訓練祕辛三張卡
第一,使用 Muon 與 AdamW 混合優化器,官方消融實驗在兩個檢查點分別少用 33.2% 與 28.6% 的步數就達到相同 loss。第二,訓練資料從約 50 億張篩到約 30 億張圖片(ReLAION 衍生語料)。第三,在「替代 GPU 平台」上完成異質 GPU 訓練。
讀稿的、畫畫的、沖洗的都是一流好手,MOSS 自己練的是中間那位畫師。
七大亮點:一關一關看
- 版面控制:用 JSON 指定文字與物件的位置。
- 文字渲染:圖中文字清晰準確,中英文都支援。
- 超長提示詞:最多 4K token,整段文案都塞得進去。
- 多種風格:動漫與寫實都能畫。
- 容易微調:Base 模型刻意不做蒸餾,保留完整訓練資訊,方便社群訓練 LoRA。
- 小而有效率:只用 5B 的主幹網路。
- 異質 GPU 訓練:不只在單一品牌的 GPU 上訓練。
重頭戲:JSON 版面魔術
先學座標:中心是原點,y 往下變大
JSON 版面使用 abs_centralized 座標:以 1024×1024 的畫布為例,中心點是原點,左右各 ±512,x 往右變大、y 往下變大,所以左上角是 (-512, -512)、右下角是 (512, 512)。方框採 yxyx 格式,順序是 [y_min, x_min, y_max, x_max]。
現場示範:一張極簡旅遊海報
官方範例是一張極簡旅遊海報。summary 先描述整張圖:奶油色背景、藍色的山、標題 EXPLORE。接著在 items 裡放兩個物件:第一個是文字,text 寫 EXPLORE,bbox 是 [-416, -384, -288, 384],翻成白話就是畫面上方、左右置中的細長標題框;第二個是一座藍色的山,bbox 是 [-192, -288, 384, 288],放在下方中間的大框。
換算成一般左上角座標,標題框是 x=128、y=96、寬 768、高 128;山景框是 x=224、y=320、576×576。方框落下後,海報就照著這份「設計稿」長出來。
第二輪:只改兩行 JSON
接著只改兩個地方:"text": "EXPLORE" 改成 "TAIWAN";山的 bbox 從 [-192, -288, 384, 288] 改成 [-192, -448, 384, 64],中心往左移 192 像素,caption 也同步改成 lower left。換算後,新的山景框左上角是 (x=64, y=320)。
為什麼重要:官方消融實驗
官方在 RealLayoutArena 做了消融實驗:同一個系統,用 JSON 版面提示拿到 1,622.87 分,純自然語言提示是 1,506.20 分(官方自測)。
不會寫 JSON?官方附了 Prompt Enhancer
官方提供一個 Prompt Enhancer Skill,可以把「我想要一張……」的點子轉成詳細描述或 JSON 版面,設計給 GPT-6 系列代理使用;附帶的腳本還會把像素座標草稿轉成中心座標 JSON。要注意兩件事:這是實驗性功能,而且座標是絕對像素,換解析度就要重算。
別的模型靠「描述」猜你要的版面,MOSS-Image 直接看「設計稿」。
評審席大比拚:官方自測的三場比賽
以下三場比賽都是官方發布的成績,畫面上每一張都蓋了「官方自測」的章。
比賽一:超長文字渲染 LongLongTextBench
這是官方自建的 240 題文學長文測試,目標文字平均約 1,340 字,指標是 Mean-6,越高越好。MOSS-Image 拿到 96.3(英文 97.1、中文 92.4);開源對手 Qwen Image 2512 是 64.9、Z-Image Base 40.8、FLUX.2 11.8。同一張表裡的閉源模型 GPT Image 2 是 99.0、Nano Banana Pro 96.6,所以 MOSS-Image 排第三。
比賽二:版面精準度 7Bench
指標是平均 IoU:指定的框和畫出來的框重疊得越多,分數越高。MOSS-Image 0.88,第二名 Ideogram 4.0 只有 0.44,Nano Banana Pro 與 Seedream 5.0 Pro 都是 0.33,Qwen Image 3.0 Pro 0.31,GPT Image 2 0.30。也就是說,它的重疊程度是第二名的兩倍。
比賽三:端到端競技場 RealLayoutArena
Elo 分數 GPT Image 2 以 1,844.35 排第一,MOSS-Image 1,698.70 排第二。這裡一定要附註:這個分數是「MOSS-Image+GPT-6 提示詞增強」的雙模型組合成績,不是生成器單獨的分數。
寫字它是前段班,排版它是第一名,但考卷是自己出的。
Base 還是 SFT?
Base 是原汁原味版,沒做蒸餾,CFG 等推理參數也沒被調過,最適合拿來訓練 LoRA,但要自己調好參數才會出好圖。SFT 在精選資料上微調過,同一個白板範例,文字分組更清楚、版面更整齊。一句話:想直接出圖選 SFT,想自己練模型選 Base。
上手教學:把參數推到官方建議值
- 解析度:總像素 1M、1.5M 或 2M,可外推 512×512 到 2048×2048。
- 長寬:任意比例,但長寬都要是 16 的倍數。
- 步數 Steps:至少 50。
- CFG:預設 3.0,建議 3.0–6.0,短提示詞可以調高。
- Shift:5.0;取樣器:Euler(Flow-matching)。
- SLG:建議負向分支跳過第 22 層(22、24、26 層都有幫助)。
SLG 小實驗
同一段提示詞、同一個 seed,分別開啟和關閉 SLG。關掉 SLG 的畫面非常寫實,但手和尺規這些細節可能會崩掉。下圖的圈選處是本頻道的觀察,生成結果每次不同。
提示詞小撇步
- 英文效果最好,中文與其他語言也支援。
- 推薦負面詞:nsfw, worst quality, bad anatomy, watermark, jpeg artifact。
- 標籤順序:品質 → 分數 → Meta → 年份 → 角色 → 作品 → 畫師 → 一般描述。
- 想精準控制換行,直接在提示詞中加入 \n 或真正的換行。
安裝管道與硬體
官方提供五個管道:Diffusers(Python)、Gradio 本機介面、ComfyUI(在 ComfyUI Manager 搜尋 MOSS-Image;Comfy-Org 另有含 INT8 模型與量化文字編碼器的重新打包版)、SGLang,以及 vLLM-Omni。SFT 整包下載約 27.2GB,其中文字編碼器約 16.8GB。官方沒有公布最低 VRAM,但提供「全 GPU/元件切換/循序省記憶體」三種模式,VRAM 不夠就選循序模式或降低解析度。
社群怎麼說:好評與限制
模型才發布兩天,大規模實測還很少,以下整理自開發者社群與第三方分析。好評:Apache 2.0、沒有營收門檻,商用很乾淨;第三方分析認為,版面變成「資料」之後可以版本控制、寫 schema 驗證,出錯時直接看哪個座標錯了;技術報告非常詳細;社群動作超快,發布約一天內就出現 4 步 DMD LoRA 與 8 步蒸餾版本,ComfyUI、SGLang、vLLM 的部署文件也第一時間到位。
吐槽與限制:亮眼分數都來自官方自建測試,沒有第三方獨立分數;最高的競技場成績要搭配 GPT-6 提示詞增強;絕對像素座標換解析度就要重算;最長的中文段落召回率較低(中文 92.4 vs 英文 97.1);不支援圖片編輯,參考圖生成只是預留功能;預設 50 步偏慢,少步數蒸餾官方說「敬請期待」;vLLM-Omni 的整合 PR 發布時尚未合併;下載量大,JSON 版面對新手也有門檻。
誰該用 MOSS-Image?
- 🟢 適合:海報、資訊圖表、電商主圖、知識卡片、UI 示意圖這類「版面先決定好」的工作;需要大量中英文字的圖;想自建、離線、商用、訓練 LoRA 的開發者。
- 🟡 再等等:需要改圖、參考圖、極速出圖的人,先等編輯功能與蒸餾版。
- 🔴 不適合:沒有 GPU、只想偶爾畫張圖的人,直接用線上 Demo 或雲端服務更省事。
結語:AI 畫圖的下一步
MOSS-Image 最大的不同,不是畫得比別人美,而是把「排版」變成可以寫程式控制的東西:版面是一份 JSON,可以版本控制、可以驗證、可以精準修改。它的跑分很亮眼,但都還是官方自測;等第三方評測出來,我會再幫大家更新。
AI 畫圖的下一步不是畫得更美,而是放得更準。
完整 12 分鐘的動畫解說(含 JSON 現場示範與參數教學)請見 YouTube 頻道「欣欣 的 AI 無限世界」。
開源 AI 繪圖模型 MOSS-Image 深度解析影片:
本文配圖為原創動畫影片截圖;圖中的生成圖都是頻道自己用 MOSS-Image 生成的,並非官方範例圖。所有分數為官方自測,資料整理至 2026 年 10 月 17 日。
#AI繪圖 #開源模型 #JSON版面 #文字渲染
Omni小說館是 NovelPD Omni 的作品發表平台: 作者用 AI 從一句話寫出完整小說後一鍵發佈,讀者可免費線上閱讀,付費解鎖與打賞的收入由作者分潤最高 85%。 更多動態請見 小茉莉 的作者專頁 與 社群河道。