 Omni小說館
2026 免費 AI 換裝實測|DressUp.ME V2.0.0 一鍵換裝深度解析:1 張照片+5 件衣服,臉會變嗎?準不準?
網購衣服最常見的失望,是收到貨才發現「跟模特兒穿的完全不一樣」。研究機構 Coresight Research 在 2023 年推估,美國線上服飾的退貨率高達 24.4%;受訪品牌中有 53% 認為,頭號退貨原因是尺寸與版型。
所以這兩年,「AI 虛擬試穿」成了電商與科技公司爭相投入的方向。今天要拆解的 DressUp.ME,是一款不用安裝、打開瀏覽器就能用的 AI 換裝工具,最近推出了 V2.0.0。我用它跑了三組實測,把操作流程、生成品質、新功能和限制一次整理清楚。
DressUp.ME 是什麼?從一張照片到整套造型
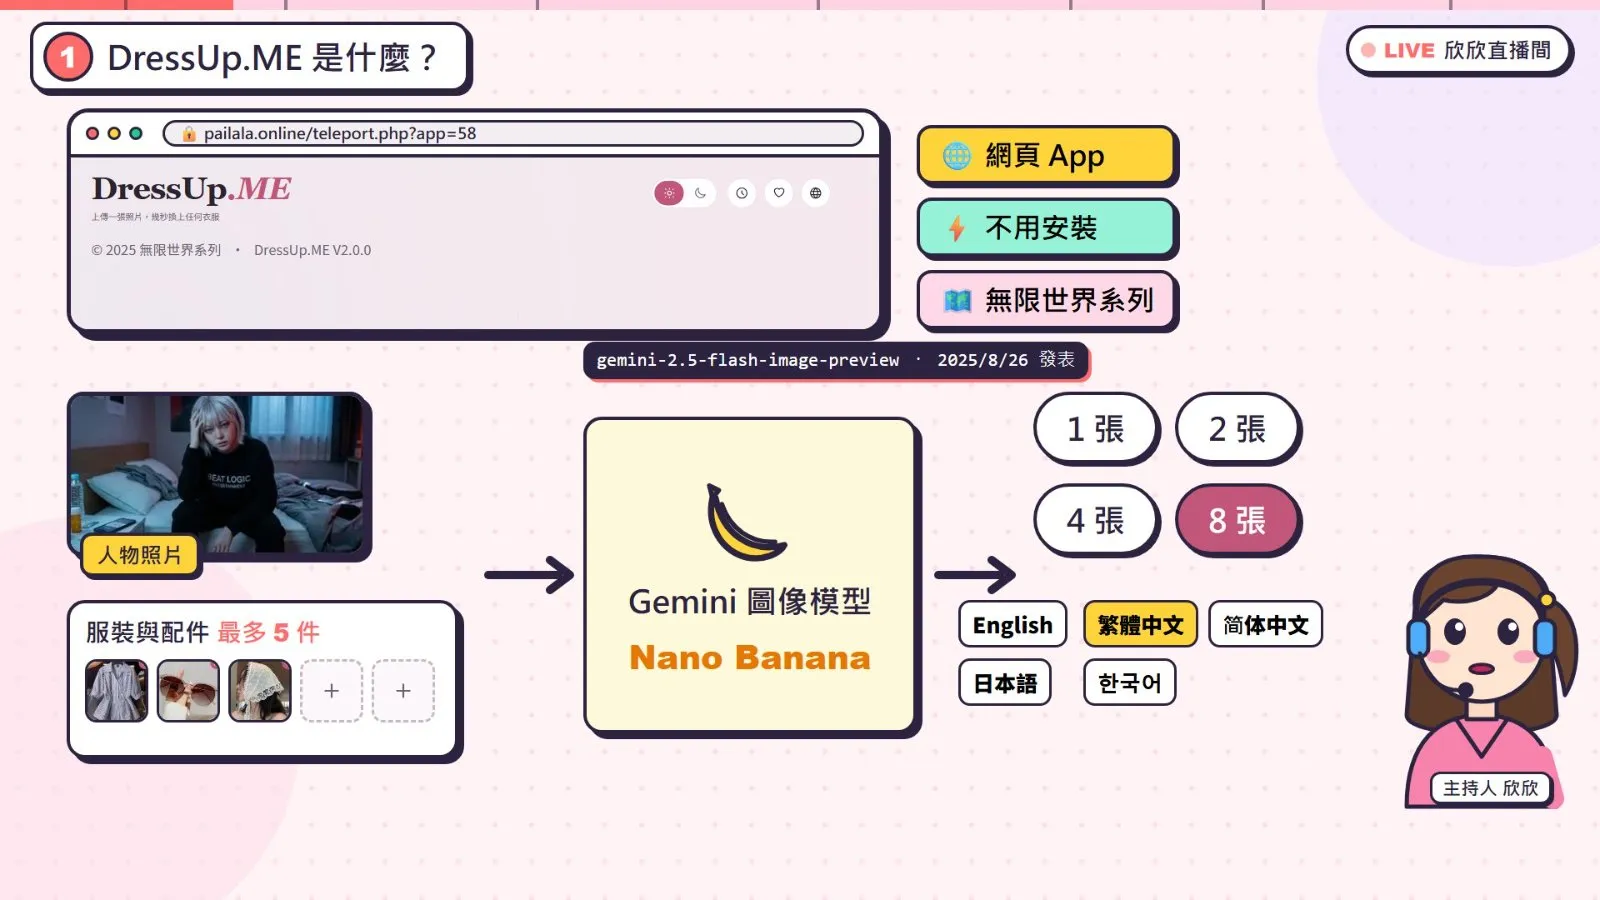
DressUp.ME 是「無限世界系列」的網頁 App,網址是 pailala.online/teleport.php?app=58。它的核心流程很單純:上傳一張人物照片,再加入最多 5 件衣服或配件的照片,App 會把這些圖片交給 Google 的 Gemini 圖像模型(程式中使用的是 gemini-2.5-flash-image-preview,也就是大家暱稱的 Nano Banana),生成你穿上這些單品的照片。
一次可以生成 1、2、4 或 8 張;介面支援繁體中文、简体中文、English、日本語、한국어 五種語言,並提供「柔和」與「深色」兩種主題。
關鍵設計:身份鎖定
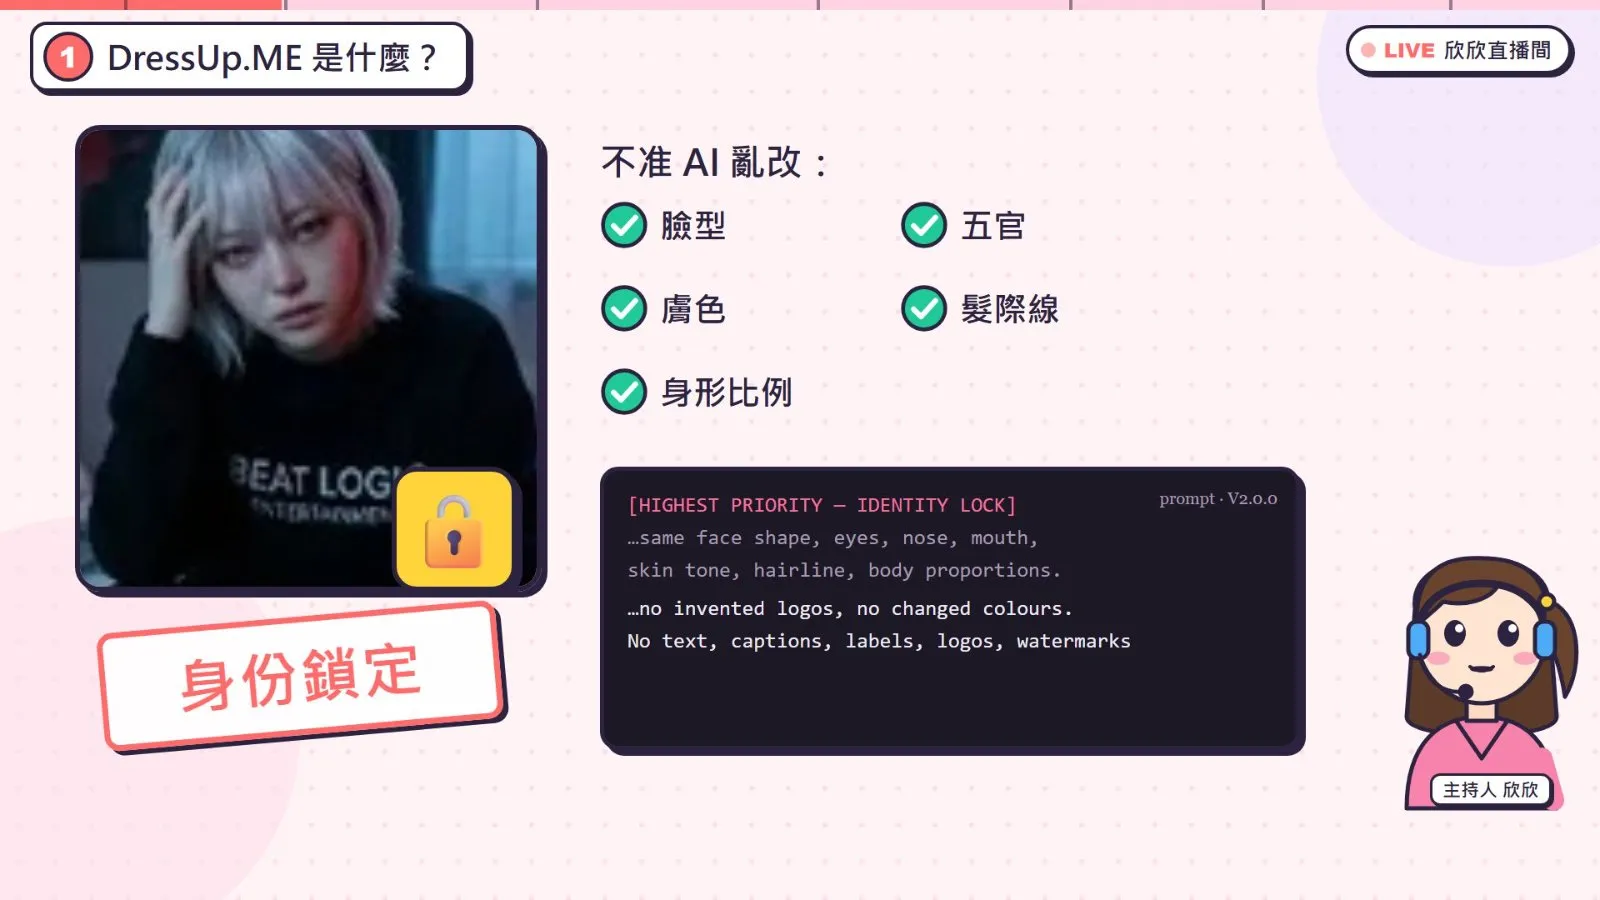
AI 換裝最讓人擔心的,是「衣服換了,臉也一起換了」。DressUp.ME 在送給模型的提示詞裡,把這件事放在最高優先級:第一段就是 [HIGHEST PRIORITY — IDENTITY LOCK],要求輸出的人物必須與原照片是同一個人,臉型、眼睛、鼻子、嘴巴、膚色、髮際線與身形比例都不能改,也不能美化、瘦身或改變年齡。
接著才是服裝還原(顏色、圖案、剪裁、長度都要照參考圖,不准自己發明 Logo)、姿勢、背景、光線與畫面比例;最後一段明確禁止任何文字、浮水印、多餘人物與變形的手部。
它不是要幫你變成另一個人,而是讓「你」穿上別的衣服。
四步驟上手:照著按就對了
DressUp.ME 的介面分成四個步驟,每個步驟的名稱都直接寫在面板上,第一次使用也不容易迷路。
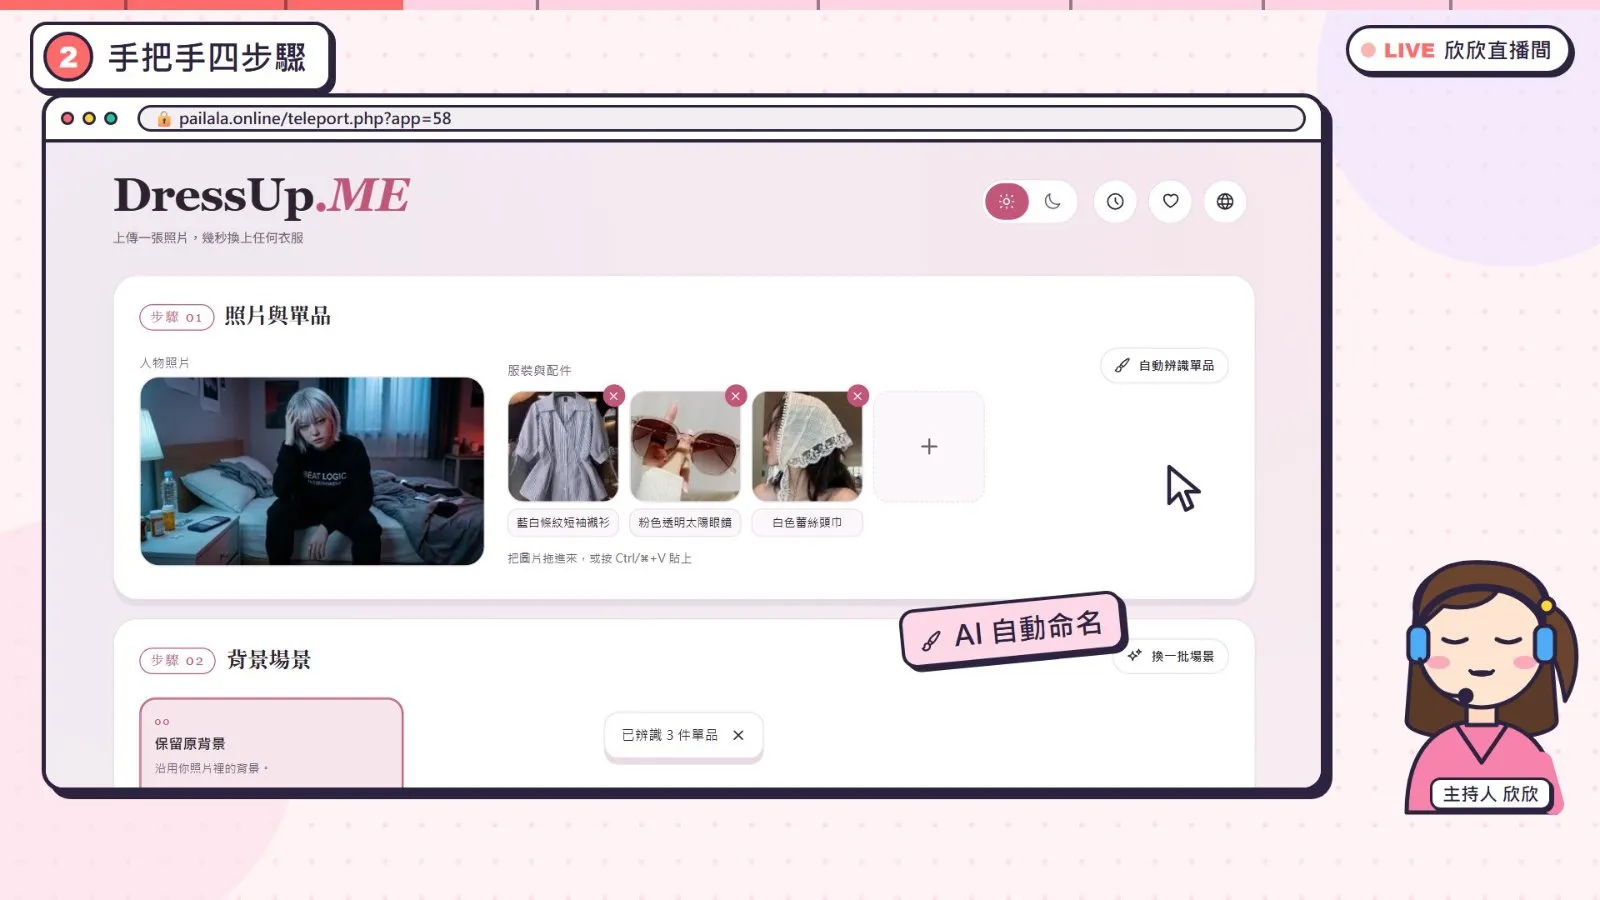
- 步驟 01「照片與單品」:在「人物照片」區塊點「上傳照片」,也可以直接把圖片拖進來,或截圖後按 Ctrl/⌘+V 貼上。接著在「服裝與配件」加入單品,最多 5 件,可以疊搭。
- 步驟 02「背景場景」:預設是「保留原背景」;按「換一批場景」,AI 會一次想出 10 個主題場景,例如巴黎街頭咖啡館、京都禪意庭園、東京霓虹街頭。
- 步驟 03「造型控制台」:選姿勢、光線、畫面比例、生成幾張,還可以在「額外指定」寫補充要求,例如「頭髮綁起來、手拿咖啡杯」。
- 步驟 04「開始生成」:按下「一鍵換裝」。按鈕會顯示「換裝中… 已完成數/總數」,需要時可以按「停止」。
上傳單品後,按右上角的「自動辨識單品」,AI 會替每一件單品取一個購物標籤式的名字。我丟進三件單品,它分別命名為「藍白條紋短袖襯衫」「粉色透明太陽眼鏡」「白色蕾絲頭巾」,名字會一起送進生成提示詞,幫助模型對齊每件單品。
這次的設定是:場景「東京霓虹街頭」、姿勢「自動搭配」、光線「霓虹夜色」、比例「3:4 直式」、生成「4 張」。
幾個實用的細節:單張圖片上限是 12 MB,人物照與單品照上傳時會先自動壓縮,降低傳輸失敗的機率;生成時一次會同時送出 2 張,4 張大約分兩批完成,每完成一張就會先顯示出來。
實測結果:哪裡準、哪裡會自己腦補
實測 1:條紋襯衫+太陽眼鏡+蕾絲頭巾
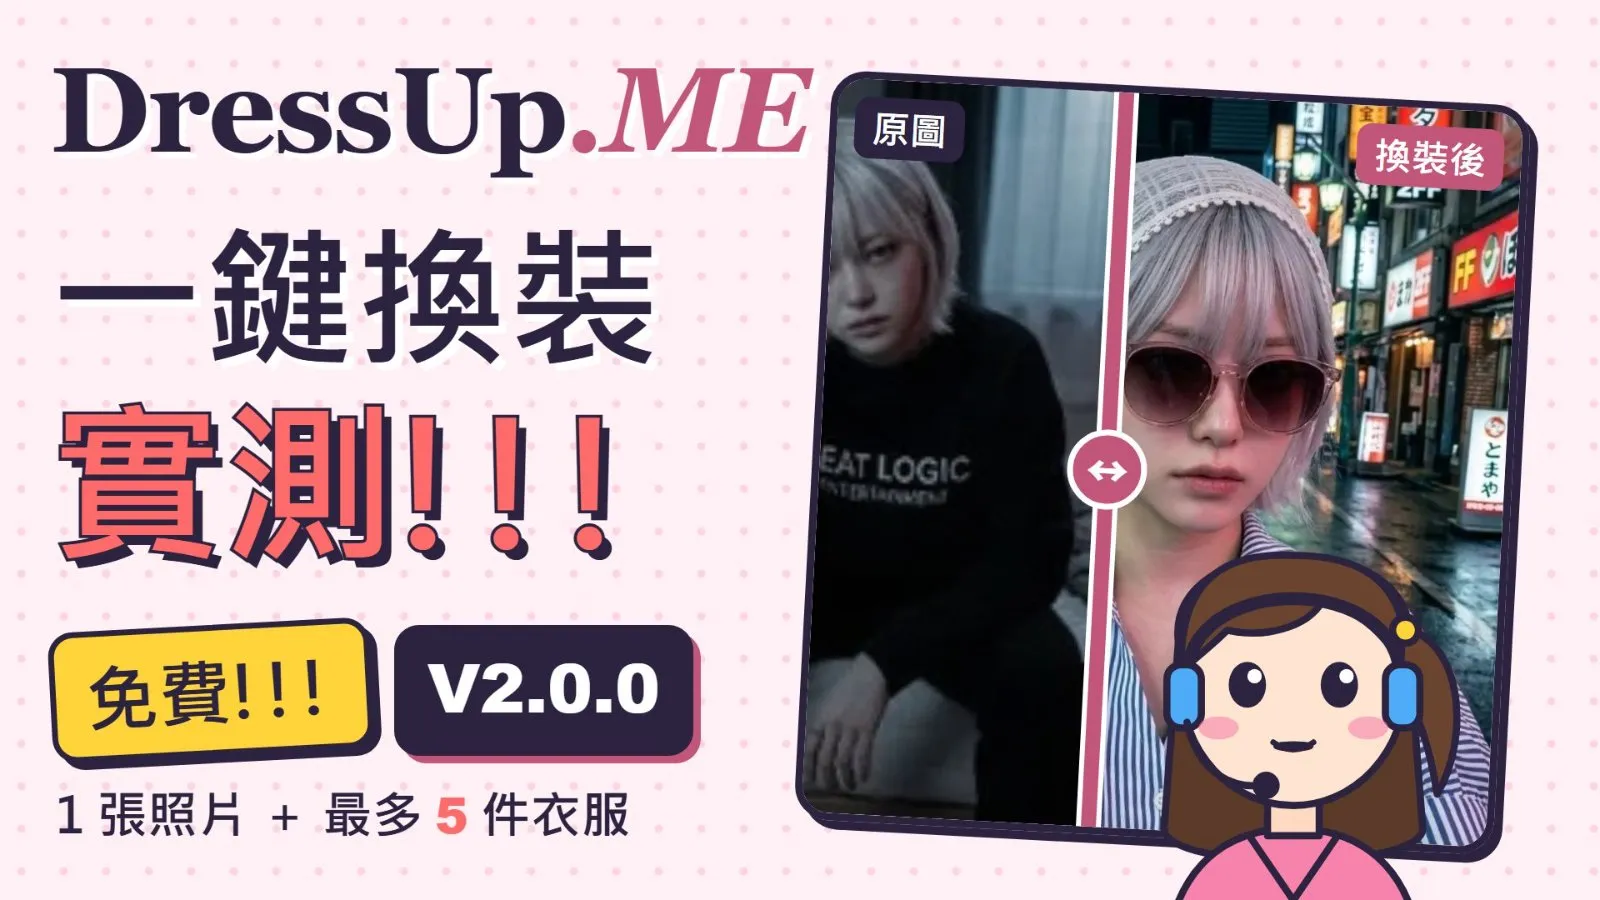
先放大看衣服本身。藍白條紋的密度與方向、襯衫的翻領、袖口的綁帶都有還原;蕾絲頭巾與粉色太陽眼鏡也都戴上了。最重要的是臉——把原圖和換裝後並排看,在這組結果裡仍然認得出是同一個人。
四張結果剛好是四種姿勢:維持原姿勢、雜誌站姿、坐姿、自拍。這不是巧合——選「自動搭配」時,App 會依照姿勢清單的順序輪流分配,第 1 張到第 8 張分別對應 8 種姿勢。想一次看完全部姿勢,選 8 張就可以。
但也有出乎意料的地方。我只給了上衣、眼鏡和頭巾,沒有提供褲子,AI 就自己替我配了一條牛仔褲;另一張還把太陽眼鏡推到頭上,造型感甚至比我想的更好。
實測 2:白色方領泡泡袖上衣
第二組只換一件白色上衣。方領、排扣、泡泡袖與腰線都很到位,日式庭園的光影也自然。不過 AI 額外加了一條珍珠項鍊,下身的牛仔短褲同樣是它自己搭的。
實測 3:保留原背景
第三組選「保留原背景」。房間、檯燈、書桌都沒有變,只有衣服與配件被替換,適合想要「同一個場景、不同穿搭」的比較。
三組實測的結論很一致:你給的單品,細節還原得很好;你沒給的部分,AI 會自己補齊。這不完全是缺點——它讓整套造型看起來完整——但如果你想精準控制,就要把下身、鞋子也一起丟進去。
想控制,就全部丟進去。
V2.0.0 新功能一次看:從智慧辨識到四宮格海報
- 智慧配件辨識:單品上傳後自動命名,名稱不對也可以在單品下方的輸入框直接修改。
- 造型控制台:姿勢有維持原姿勢、雜誌站姿、坐姿、自拍、回眸、背影、俯角、斜躺 8 種,外加「自動搭配」;光線有沿用原照片、柔和日光、黃昏金光、棚拍打光、霓虹夜色;畫面比例有同原照片、3:4 直式、1:1 方形、9:16 限動。
- 試衣鏡:點開結果就能左右拖曳滑桿,原圖與換裝後一秒對照;鍵盤左右鍵可以微調。
- 我的衣櫥:喜歡的造型按愛心收藏,下次打開還在。
- 做成海報:把最多四套造型拼成一張 2×2 海報,下方附 DressUp.ME 與 pailala.online 字樣,適合直接分享。
- 以此為底:把任何一張結果設成新的人物照片,再加新的單品繼續換,一層一層疊出完整造型。
- 雙主題與生成紀錄:柔和/深色一鍵切換;生成紀錄會保存最近的作品,可以隨時重新開啟。
其中我最常用的是「以此為底」。與其一次塞進所有要求,不如先換外套、再換鞋、最後換場景,每一步都能確認結果,比較不會讓模型「一次改太多」。
放在產業裡看:大廠怎麼做 AI 試穿?
大公司也在做 AI 試穿。Google 在 2025 年 6 月推出實驗性的試穿 App Doppl,讓使用者用全身照建立「數位分身」來試穿衣服;但 Google Labs 隨後宣布,Doppl 於 2026 年 4 月 30 日關閉,試穿功能改到 Google 的商品頁與服飾圖片搜尋結果中。
和大廠的商品頁試穿相比,DressUp.ME 的定位更像「個人造型工作室」:任何衣服照片都能丟、一次最多 5 件可以疊搭,還能控制姿勢、光線、比例,直接產出社群素材。
但它和所有生成式 AI 一樣有共同的限制:模型畫的是「看起來合理」的樣子,不是在模擬布料與身形。拿它來看風格、顏色與整體氣氛很準,但不能拿來判斷尺寸合不合身。
讓效果更好的五個技巧:少踩雷、多抽卡
- 人物照要正面、清楚、光線均勻:模糊或逆光的照片,模型也很難還原五官。
- 衣服照用去背或平拍:背景越乾淨,模型越不會把背景元素誤認成衣服的一部分。
- 不想被腦補,就把下身與鞋子一起丟進去:沒給的部位,模型會自己決定。
- 名稱辨識錯了就手動改:單品名稱會進入提示詞,改正確能幫助模型對齊。
- 一次改一件事:不滿意就「重生成」,或用「以此為底」分步驟調整;生成式 AI 每次結果不同,多抽幾次很正常。
隱私與使用守則:照片去了哪裡?
從 App 的程式行為來看,你上傳的照片會送到 Google Gemini API 生成;「我的衣櫥」與「生成紀錄」則存在你自己的瀏覽器(IndexedDB),紀錄最多保留最近 40 筆。換一台裝置或清除瀏覽器資料,紀錄就不會跟著走。
另外,Gemini 2.5 Flash Image 生成的圖片會內嵌 Google 的 SynthID 隱形浮水印,可用來辨識 AI 生成內容。最重要的守則只有一條:只上傳你自己,或已經取得同意的人的照片。
結語:風格預覽器,不是尺寸測量器
用三句話總結這次實測:
- 免費、打開就能用:免安裝,一張照片+最多 5 件單品就能開始。
- 控制項很完整:姿勢、光線、比例都能選,還能做成四宮格海報、用「以此為底」一路疊下去。
- 看風格超準,尺寸請看官方尺寸表:沒給的單品 AI 會自己補,想控制就全部丟進去。
它最適合回答的問題是「這套我穿起來風格對不對」,而不是「這件 M 號我穿會不會太緊」。
想自己試試看,免費使用;完整 6 分鐘的動畫實測版請見 YouTube 頻道,裡面有每個按鈕的實際操作畫面與三組實測的放大檢查。
本文配圖為原創動畫影片截圖,畫面中的換裝結果為 DressUp.ME 實際生成的 AI 圖片,光線示意圖為色調模擬;退貨率為研究機構推估,資料整理至 2026 年 10 月 15 日。
👗 立即試玩 DressUp.ME(免安裝・免註冊):
https://share.gemini.google/EnbfE3RSynIl
👉 AI一鍵換裝實測|DressUp.ME V2深度解析:
#AI換裝 #虛擬試穿 #NanoBanana #一鍵換裝
Omni小說館是 NovelPD Omni 的作品發表平台: 作者用 AI 從一句話寫出完整小說後一鍵發佈,讀者可免費線上閱讀,付費解鎖與打賞的收入由作者分潤最高 85%。 更多動態請見 小茉莉 的作者專頁 與 社群河道。